2026年8月4日
1 分钟
推理优化层,应该和弹性调度解耦
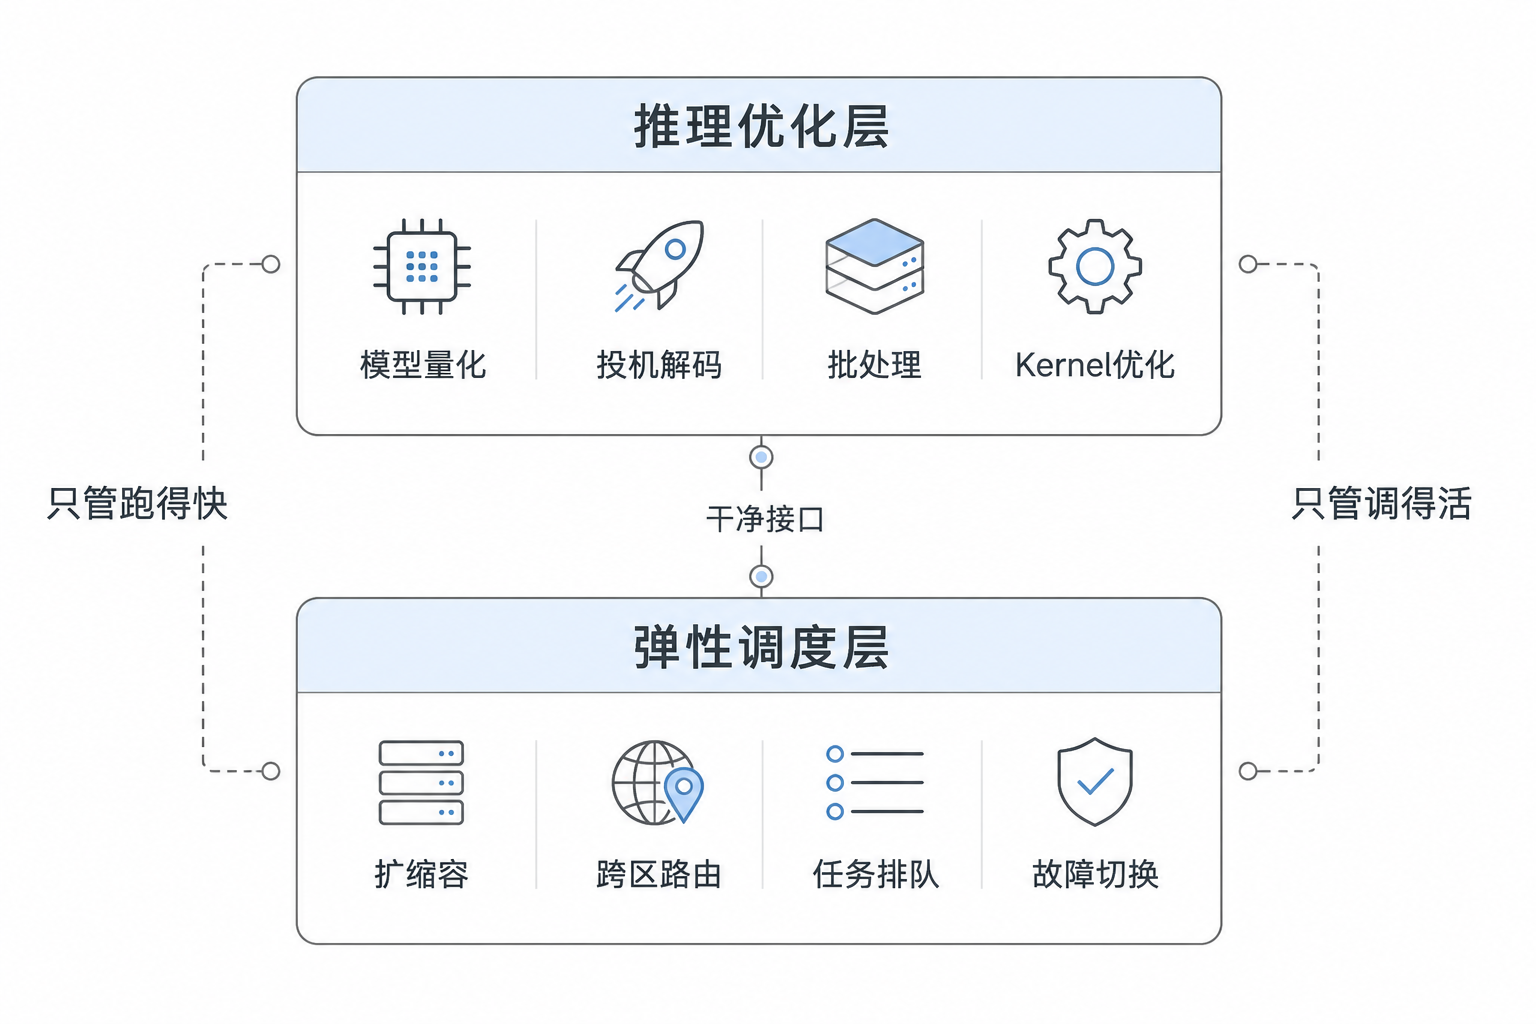
我们做推理服务,绕不开一个选择。优化推理性能,是把它和底层的资源调度绑在一起做,还是分开做。我们选分开,而且越来越确信这个选择是对的。 推理优化有哪些事 模型量化,用更低精度换速度,比如从浮点十六位压到八位,显存和计算都省。投机解码,先猜几步再验证,减少串行等待,用户看到的是首字更快出来。批处理,把...
探索前沿技术,分享实践经验,追踪行业动态
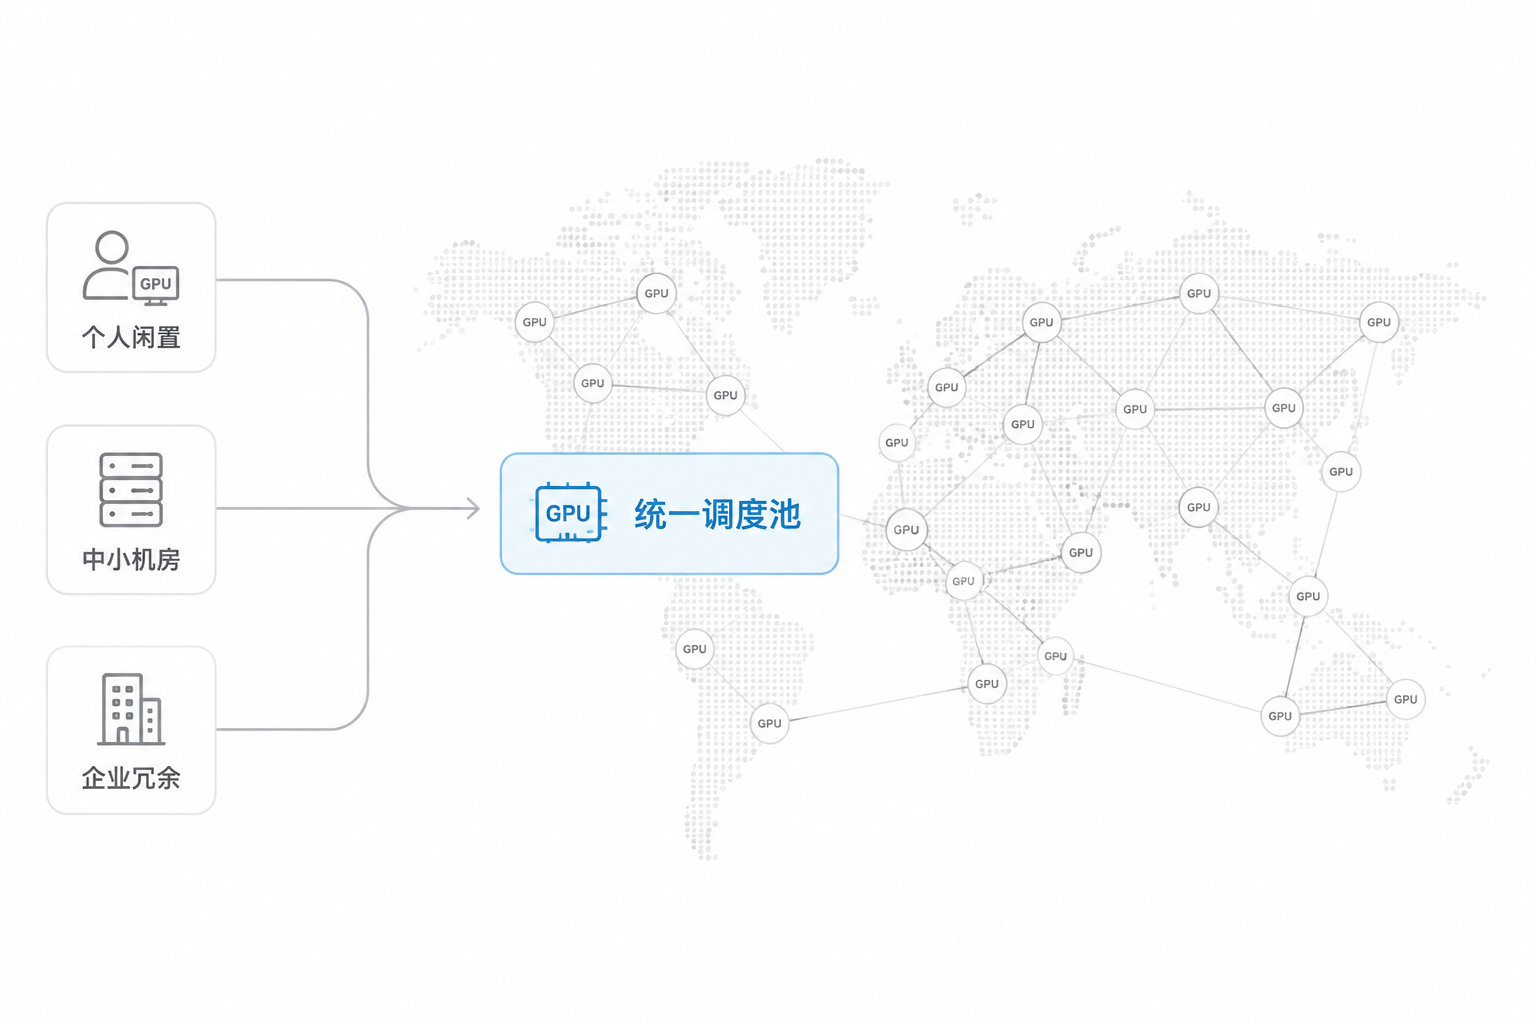
我们做整合调度,常被人问,散在各处的显卡,真能当成一个池子用吗。我们的答案是能,而且这件事的价值被很多人低估了。 闲置显卡的数量大得超出直觉 地球上闲置的显卡数量大得超出直觉。有人买了高端卡挖矿或者跑项目,用一阵就闲置了,机器还通电,卡还好的,就是没活干。这些卡单个看不值一提,聚起来是一张覆盖全球的...
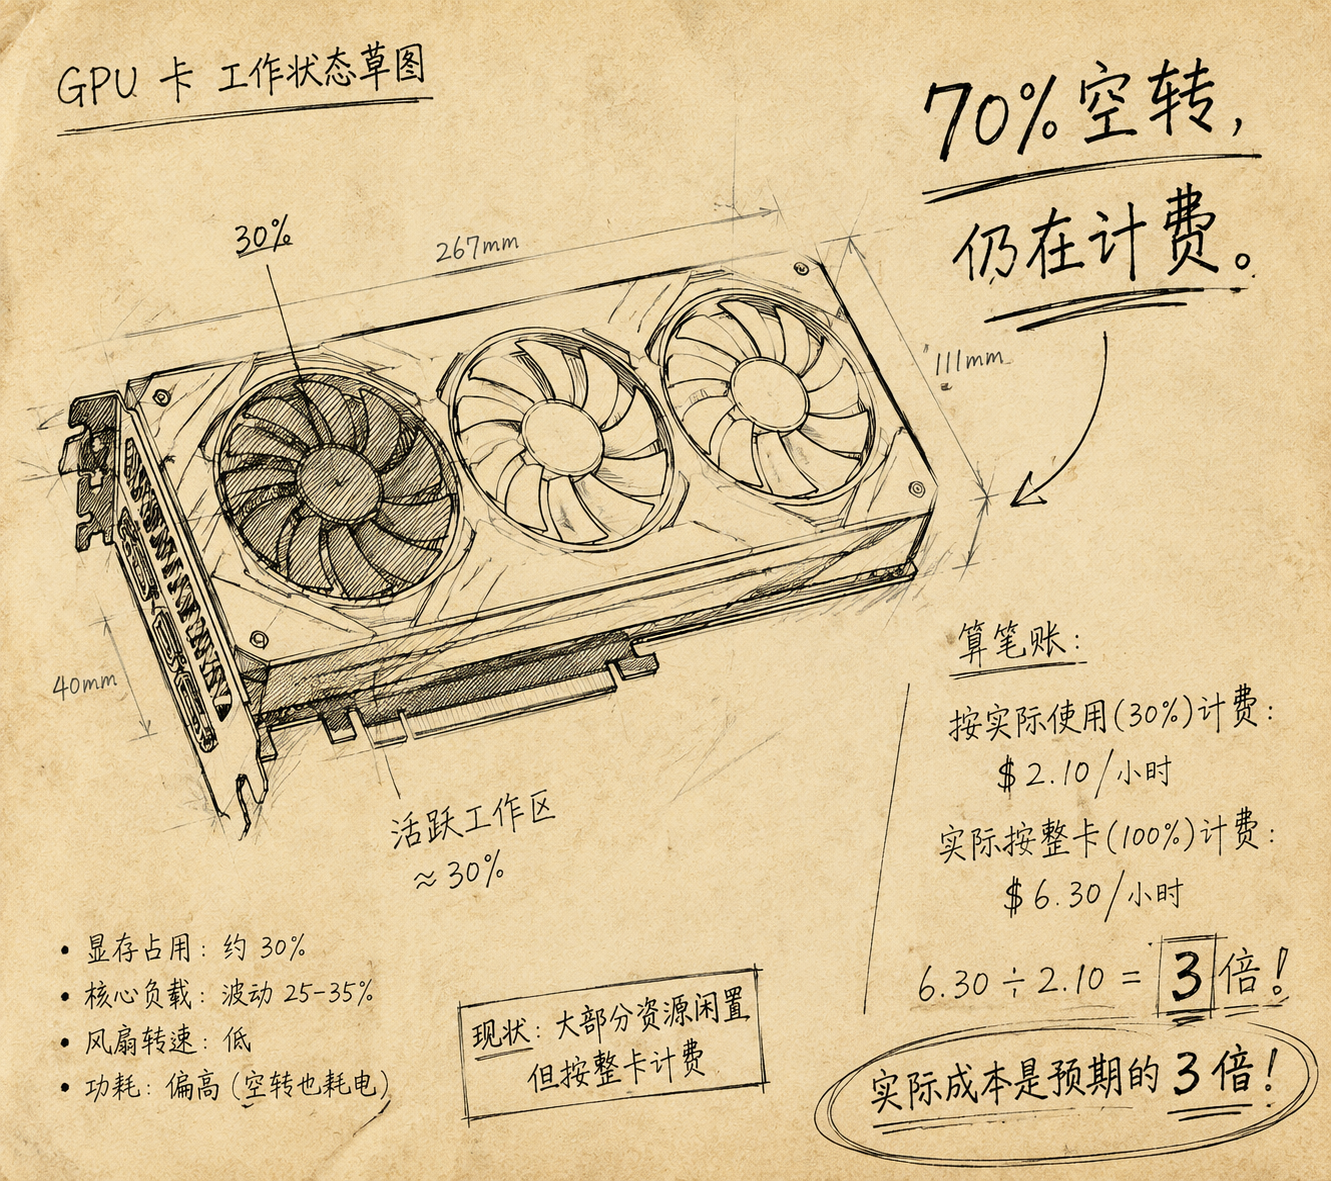
我们跟客户算账,经常被单价带偏。A 家卡比 B 家便宜两成,客户就觉得 A 家划算。我们一般会多问一句,你那张卡实际用满了多少。 利用率三成,等于单价翻三倍多 答案常常不太好听。很多团队卡的利用率在三成到四成之间。也就是说,你花一百块租的卡,只有三四十块真正在干活,剩下的大半在空转,钱照扣。利用率三...
7 月 27 日晚,月之暗面在 Hugging Face 开放了 Kimi K3 的完整模型权重,同步公开技术报告和三项训练基础设施技术。这是全球首个迈入 3 万亿参数级别的开源模型,开源社区的大模型军备竞赛进入新阶段。 我们在共绩算力平台上第一时间对 Kimi K3 做了系统实测,结合官方技术报...
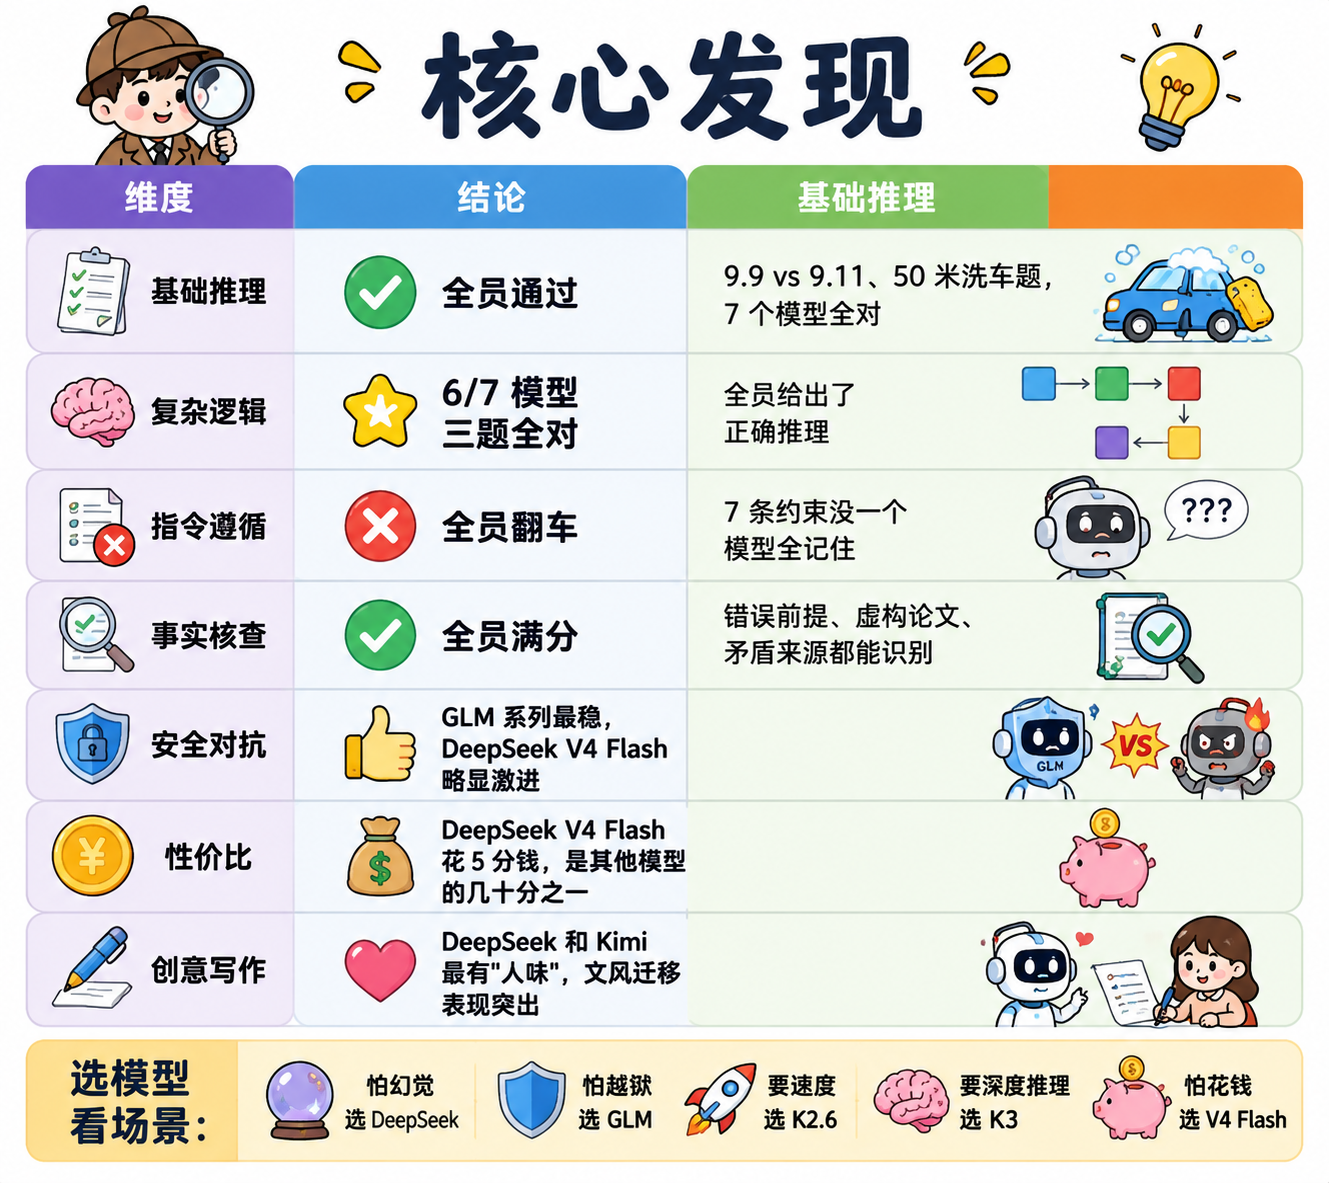
网上有一套 35 道的大模型测评题,来源是晚点测评、量子位、洛小山这些平台的真实翻车记录。9.9 和 9.11 哪个大、50 米洗车题、蒙提霍尔变体,每一道都让 GPT-5 和 Claude 翻过车。 我们把这套题在共绩算力上对 7 个国产模型跑了一遍。147 次调用,34 分钟,花了 5 块 4。...
我们做算力平台久了,有个感受越来越强。用户要的早就不只是卡了。 早几年比单价,用户把运维苦自己吞了 早几年,大家比的是谁卡多、谁单价低。你八折我七折,卷到最后,用户省了单价,却把开机器、配环境、管集群、盯账单这些事自己吞了。我们见过一个创业团队,为了省两成单价选了家裸机租赁,结果招了个专职工程师专门...
前几天在 GitHub 上刷到一个项目叫 play-video,说是一个交互动画出片引擎,从代码到出片命令全是 AI 写的。我有点不信,就 clone 下来跑了一遍。 跑完之后我信了。5 个场景,每个都能动,每个都有配乐,鼠标划过去画面里的东西还会"受惊"。我把它录成了 GIF 放在下面,你可以直接...
前几天在 GitHub 上刷到一个项目叫 play-video,说是一个交互动画出片引擎,从代码到出片命令全是 AI 写的。我有点不信,就 clone 下来跑了一遍。 跑完之后我信了。5 个场景,每个都能动,每个都有配乐,鼠标划过去画面里的东西还会"受惊"。我把它录成了 GIF 放在下面,你可以直接...
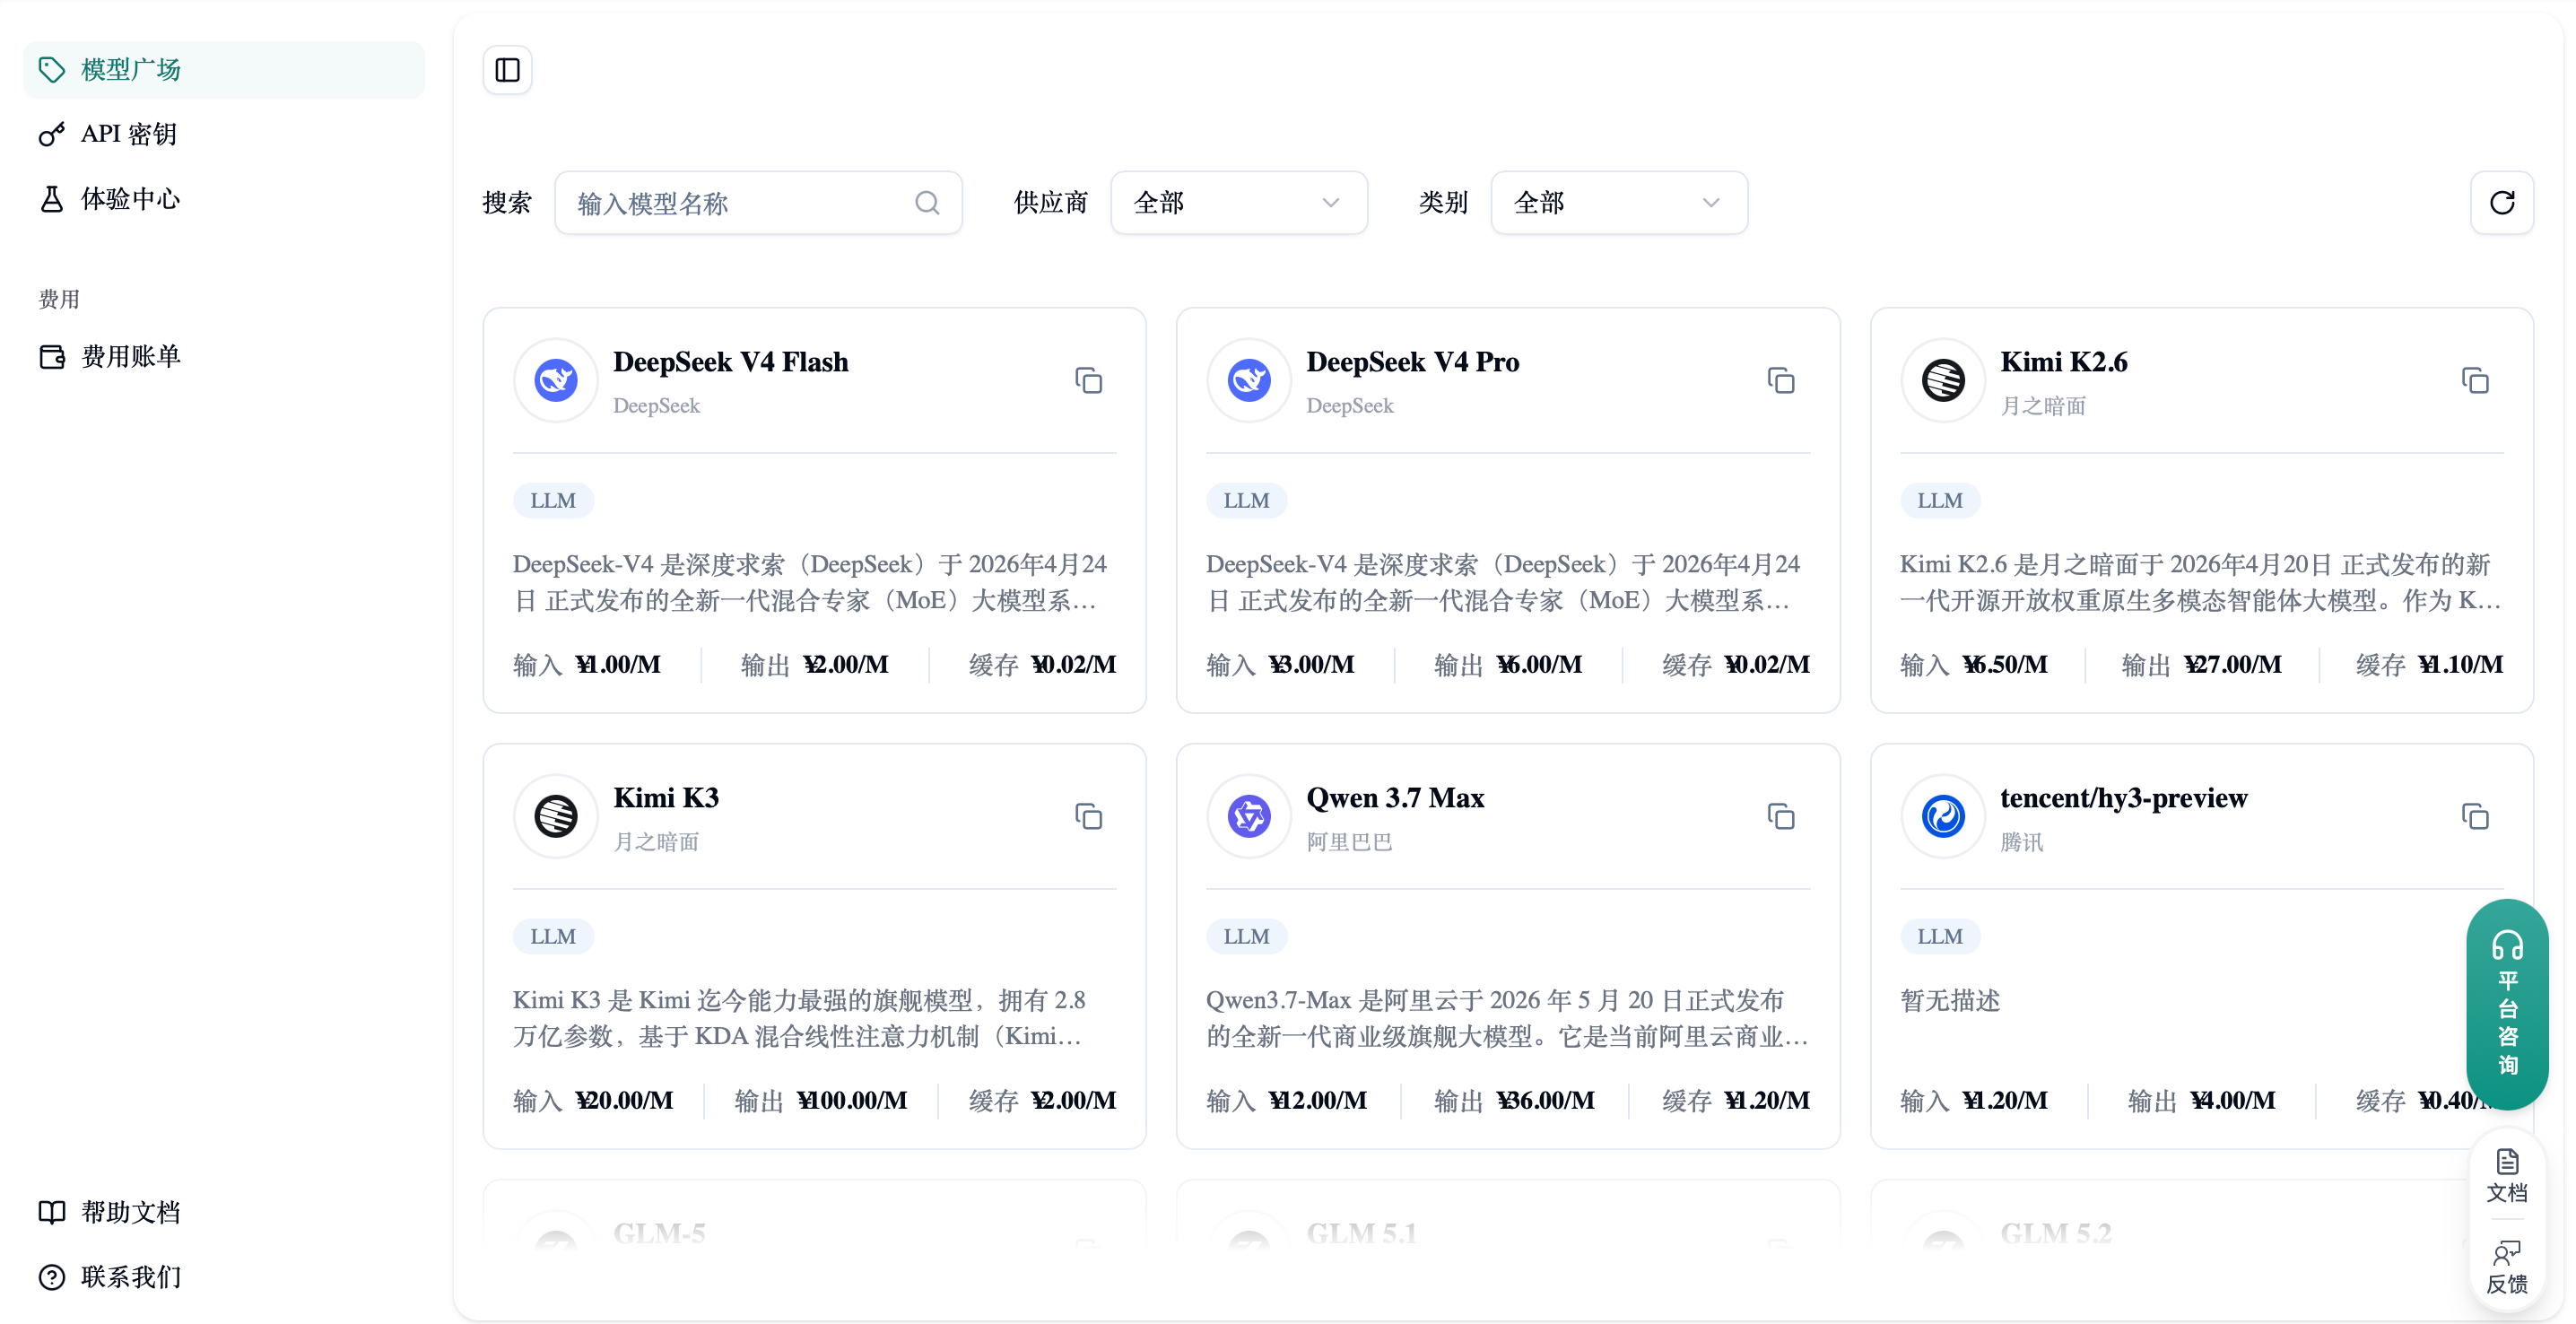
国产大模型越来越多,选型成了开发者的麻烦事。既然咱们把 DeepSeek、Kimi、GLM 这些主流模型都接进平台了,干脆自己拿同一套题跑一遍,7 个模型拉出来溜溜,看看到底谁好用。不吹不黑,结果先放下面。 测了什么 我挨个点了一遍,共有 7 个国产顶尖模型: - DeepSeek V4 Flash...
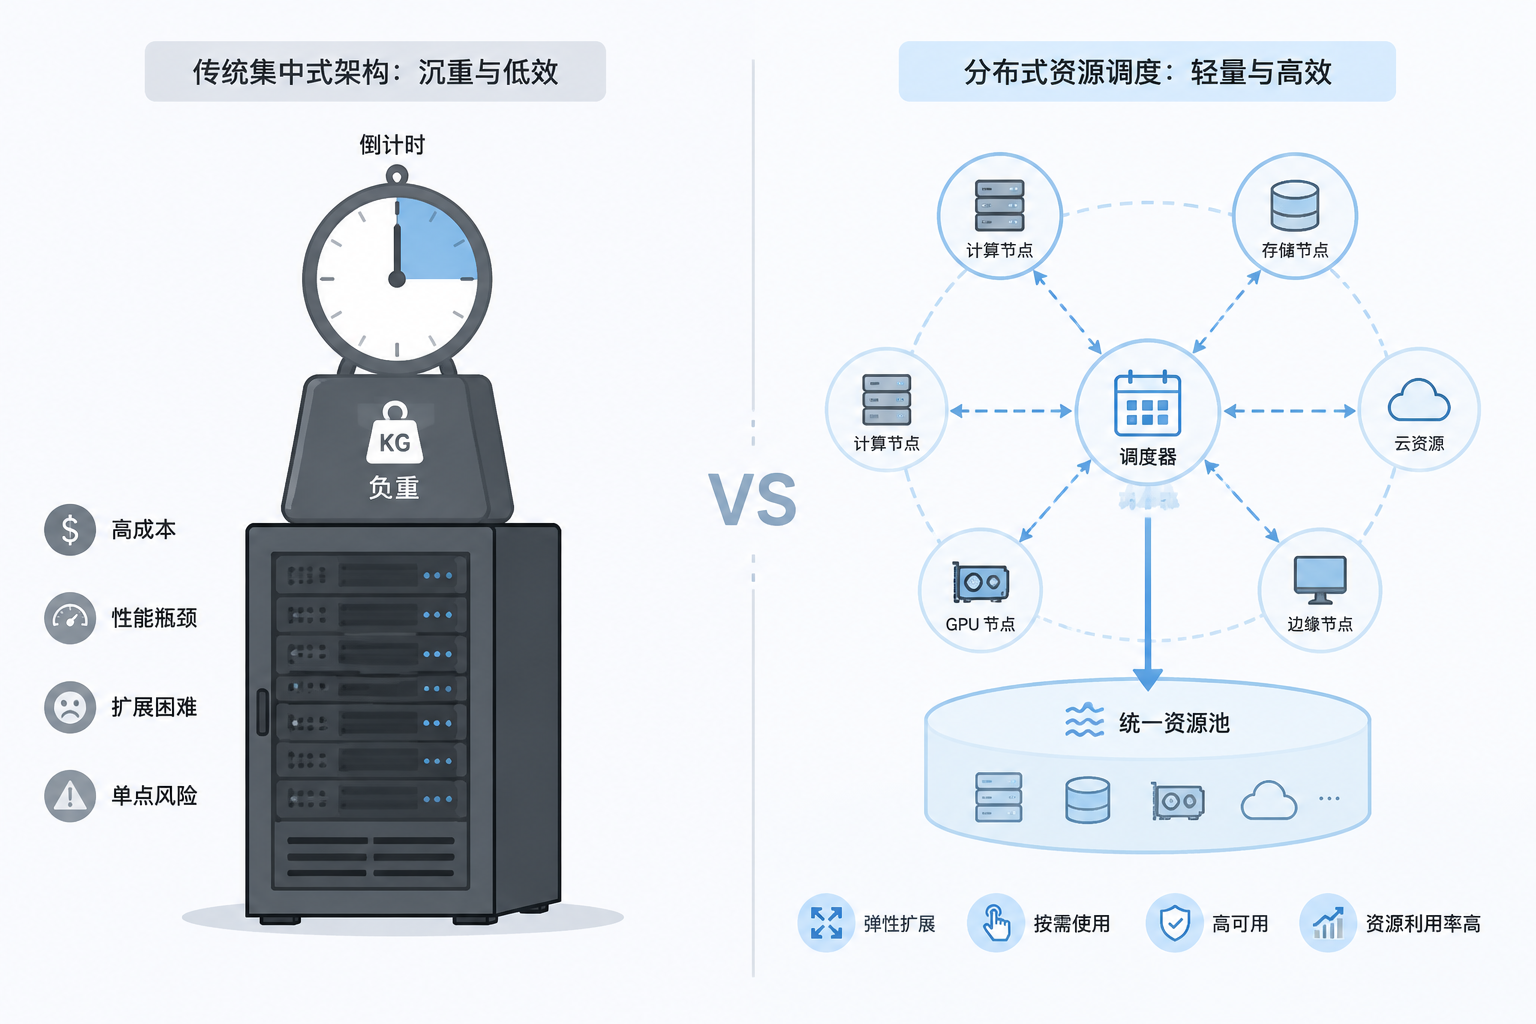
我们和很多同行聊过一个话题。做 GPU 云,是不是一定要自己建机房、自己买卡。结论是未必。 重资产:可控,但背着折旧 重资产的路子大家熟。自己攒机器,自己运维,自己扛机房成本。好处是可控,卡就在自己手里,出了事自己能拍板。坏处也明显,钱压在硬件上,技术迭代一快,上一代卡还没回本,新一代就出来了,那笔...
国产大模型越来越多,选型成了开发者的麻烦事。既然咱们把 DeepSeek、Kimi、GLM 这些主流模型都接进平台了,干脆自己拿同一套题跑一遍,7 个模型拉出来溜溜,看看到底谁好用。不吹不黑,结果先放下面。 测了什么 我挨个点了一遍,共有 7 个国产顶尖模型: - DeepSeek V4 Flash...
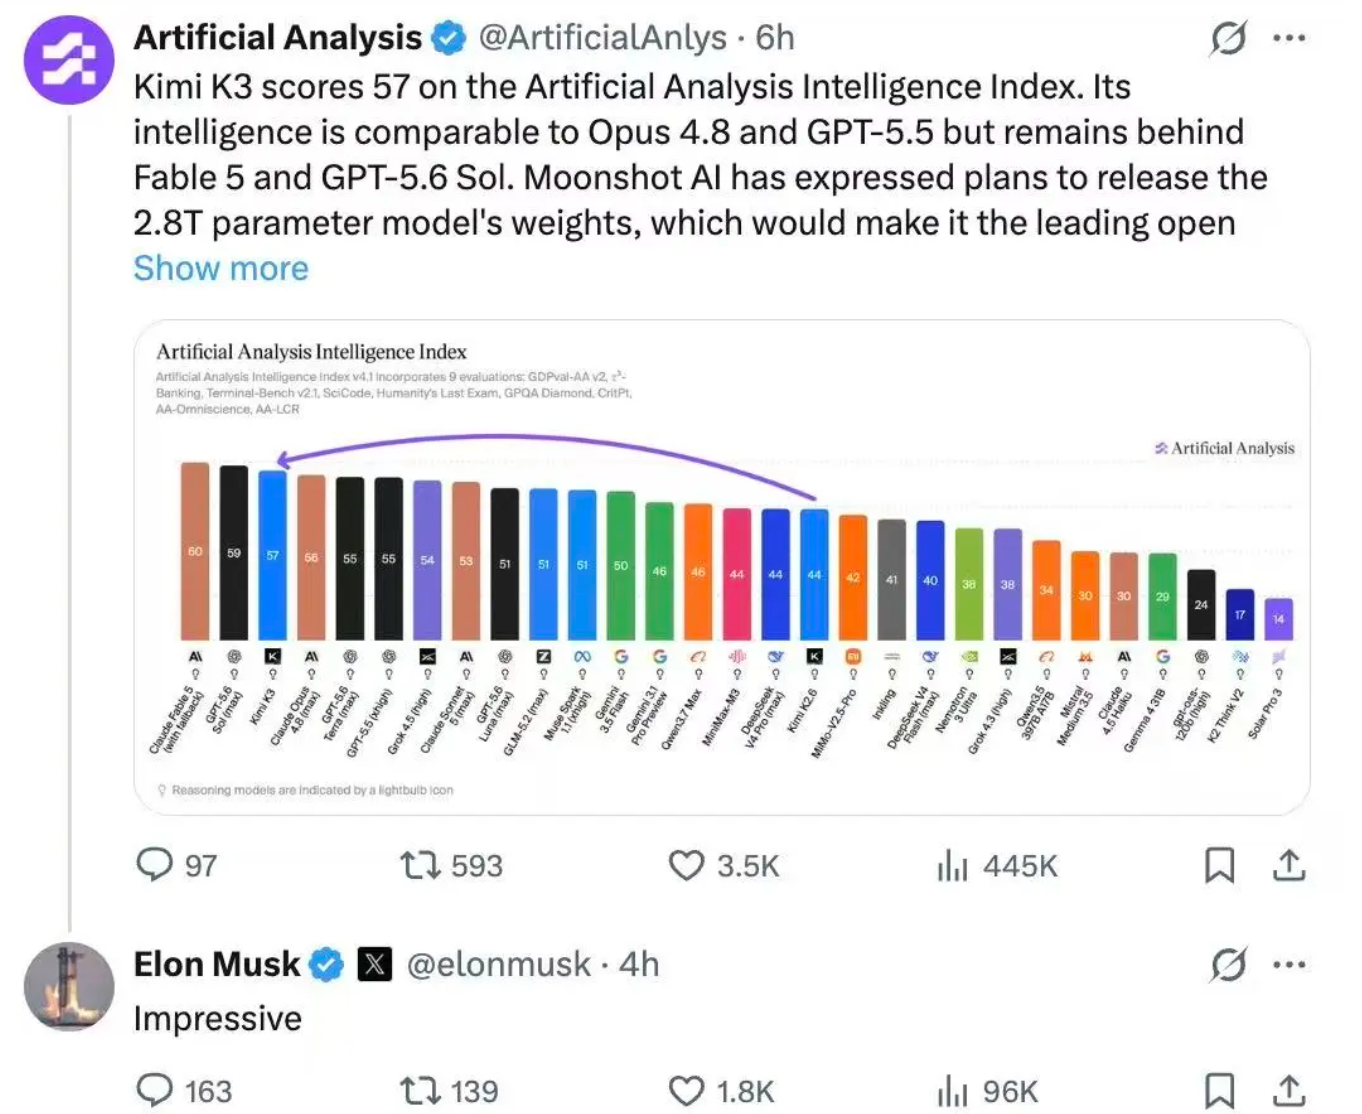
01 引言:一张牌拍在桌上 2026 年 7 月 16 日,世界人工智能大会开幕前一天,月之暗面把一张牌拍在了桌上——Kimi K3。2.8 万亿参数,全球首个开源 3T 级模型,权重承诺 7 月 27 日前完全开放。消息一出,Hacker News 的讨论帖冲上 1023 分、630 条评论,海...
01 引言:一张牌拍在桌上 2026 年 7 月 16 日,世界人工智能大会开幕前一天,月之暗面把一张牌拍在了桌上——Kimi K3。2.8 万亿参数,全球首个开源 3T 级模型,权重承诺 7 月 27 日前完全开放。消息一出,Hacker News 的讨论帖冲上 1023 分、630 条评论,海...
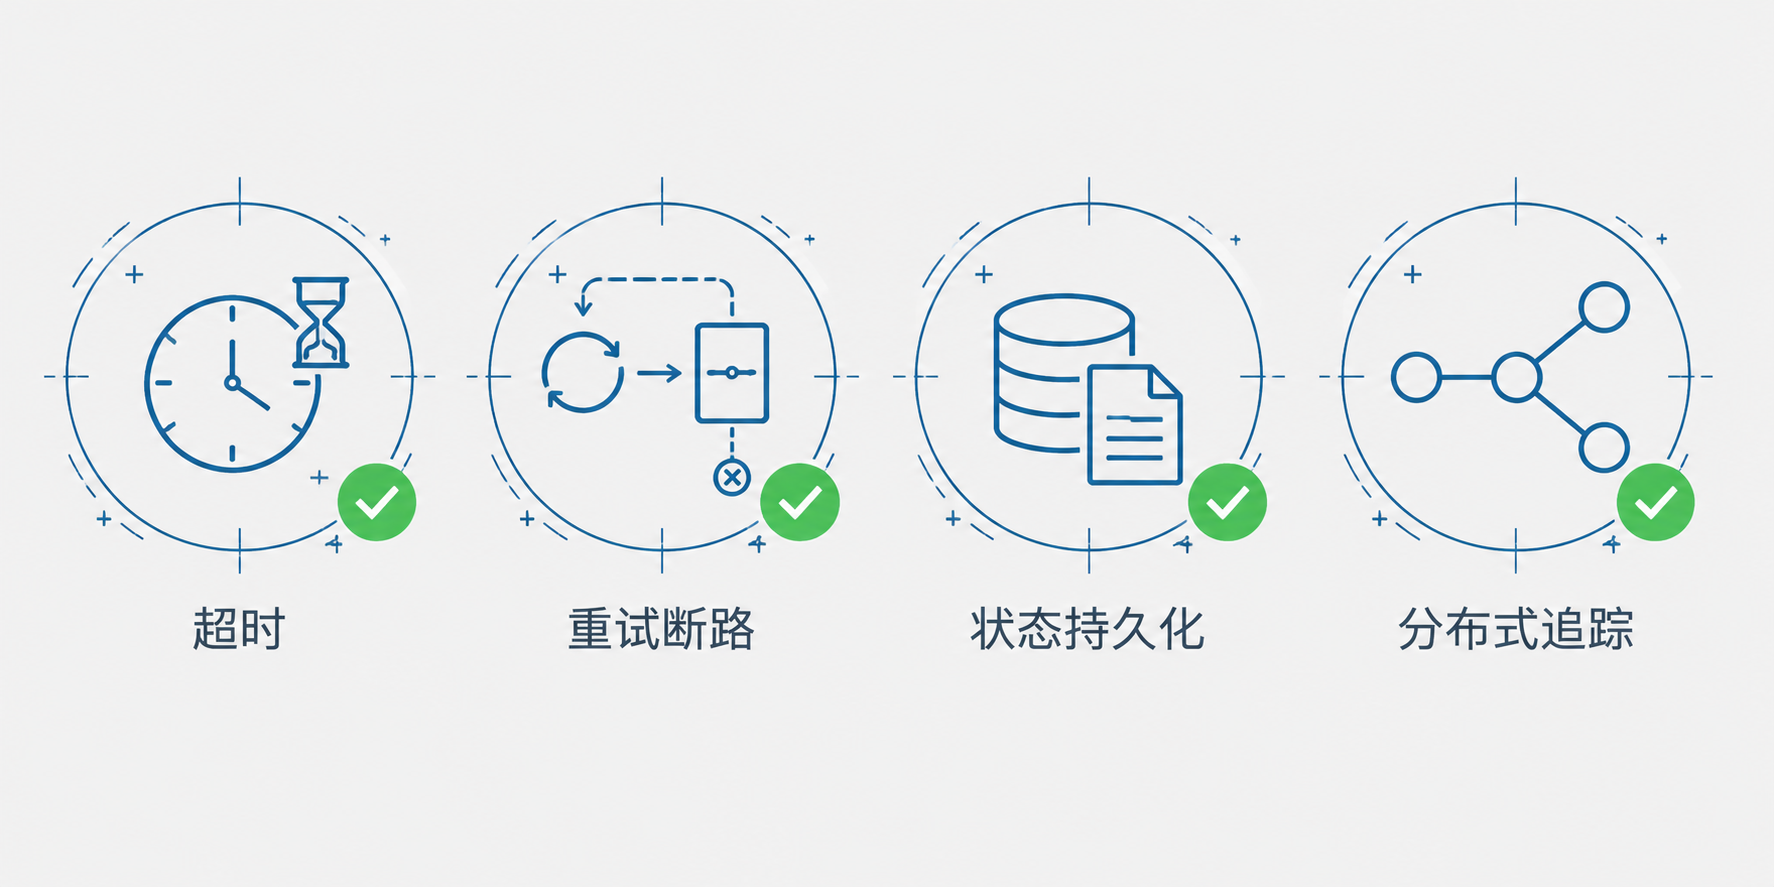
很多团队把 Agent 从 demo 搬上生产,第一道坎不是模型效果,是基础设施。demo 里跑通一次不代表能天天跑。我们帮不少团队踩过这个坑,缺的往往是几个基础设置。 超时:别让一个慢接口拖死整条链 Agent 调一个工具,对方没反应,不能无限等。每个调用得有超时,到了时间要么换路要么报错。我们见...
我们帮客户组多节点训练集群,常被一个误解绊住。客户说,给我八张卡,我要八倍的算力。我们说,八张卡给你了,但你大概率拿不到八倍。 多卡不是简单的加法。卡与卡之间要通信,要同步梯度,要抢同一块内存和带宽。这些开销不处理,八张卡可能只给你四倍,甚至更糟,卡越多互相拖累越明显。我们见过一个客户,八卡训练速度...
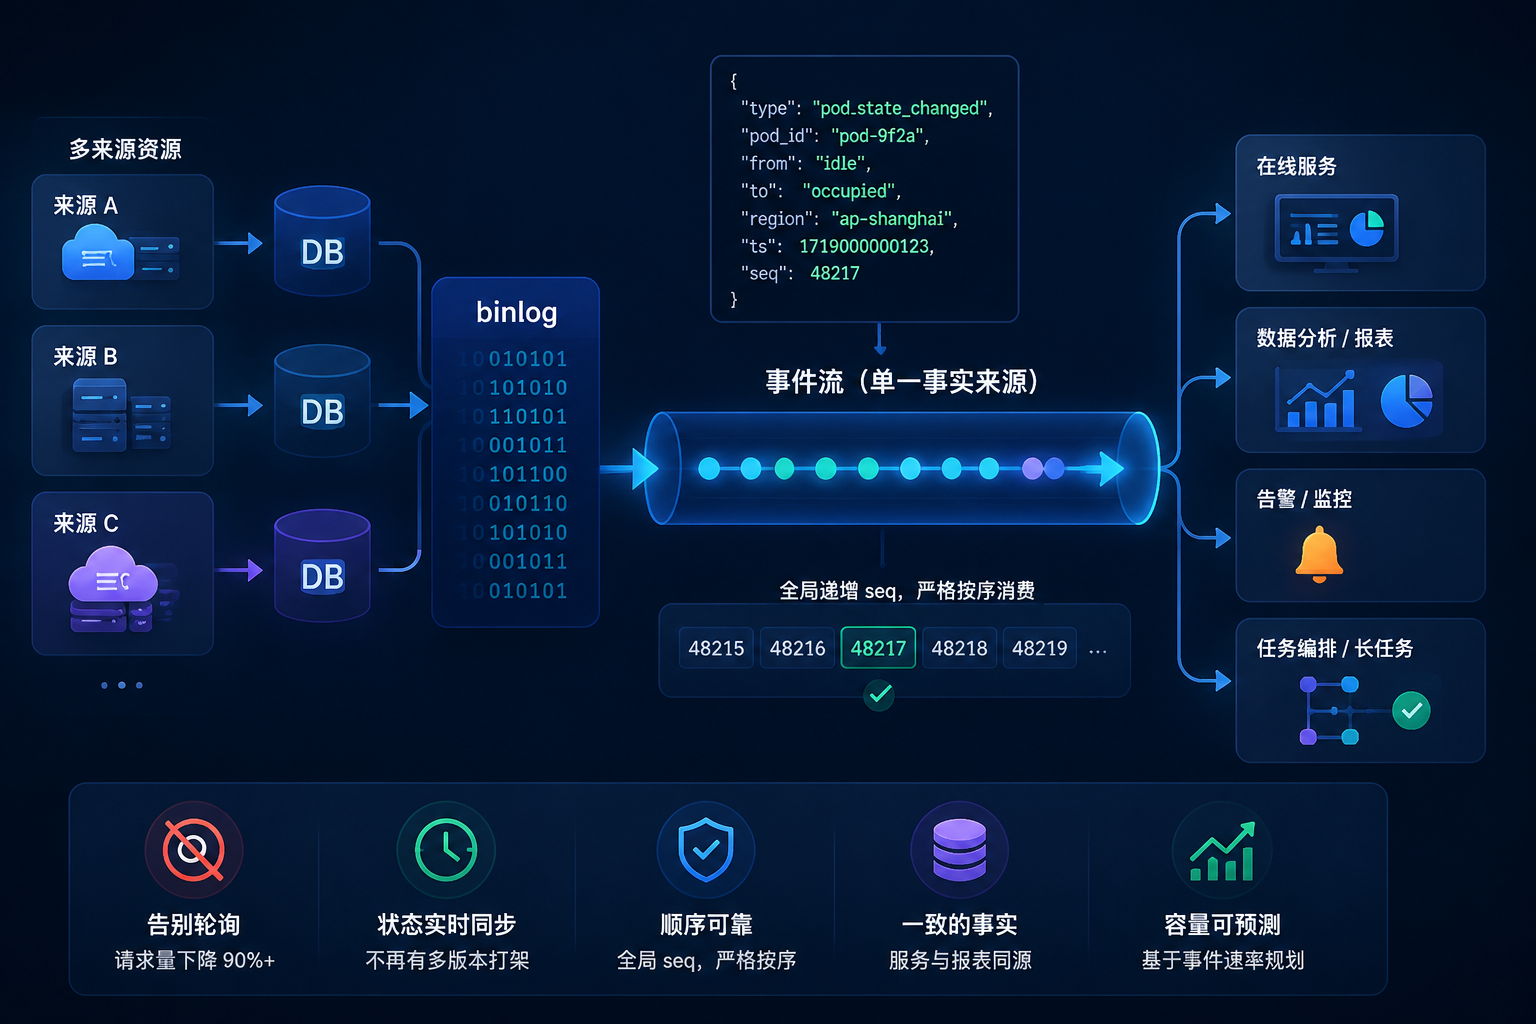
我们管着一堆来源不同的资源,机器来自不同渠道,状态分散在各家的接口后面。最早和很多团队一样,用定时任务去各家轮询,把结果拉回来比对。资源少的时候十分钟问一次,勉强够用。 1.轮询越走越重 后来发现这条路走不动。轮询频率低了,状态滞后,用户看到的和真实情况对不上,他以为机器还活着,其实早被回收了,提交...
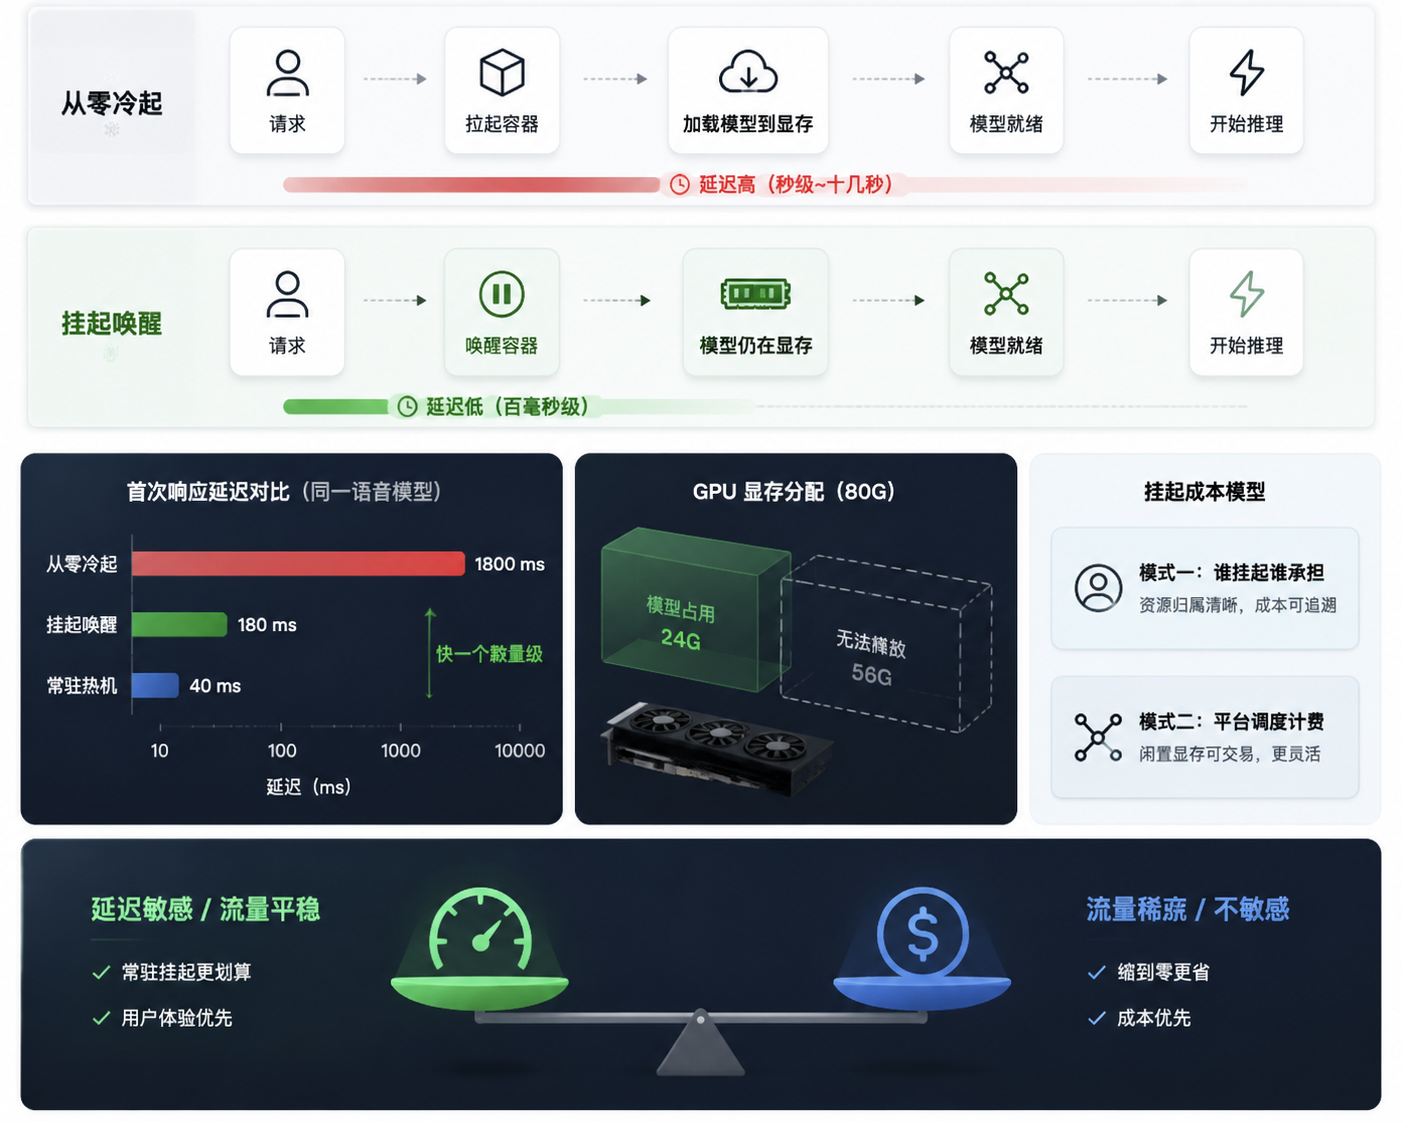
做 Serverless GPU 的团队迟早要面对一个问题。函数平时缩到零,来请求了再起机器。从零到能干活,中间那段等待就是冷启动。 延迟分两层,常被混为一谈 用户感受到的延迟分两层。一层是平台把容器拉起来、把模型权重加载进显存的时间,这部分平台能优化。另一层是物理上的硬约束,模型越大,往显存里搬的...
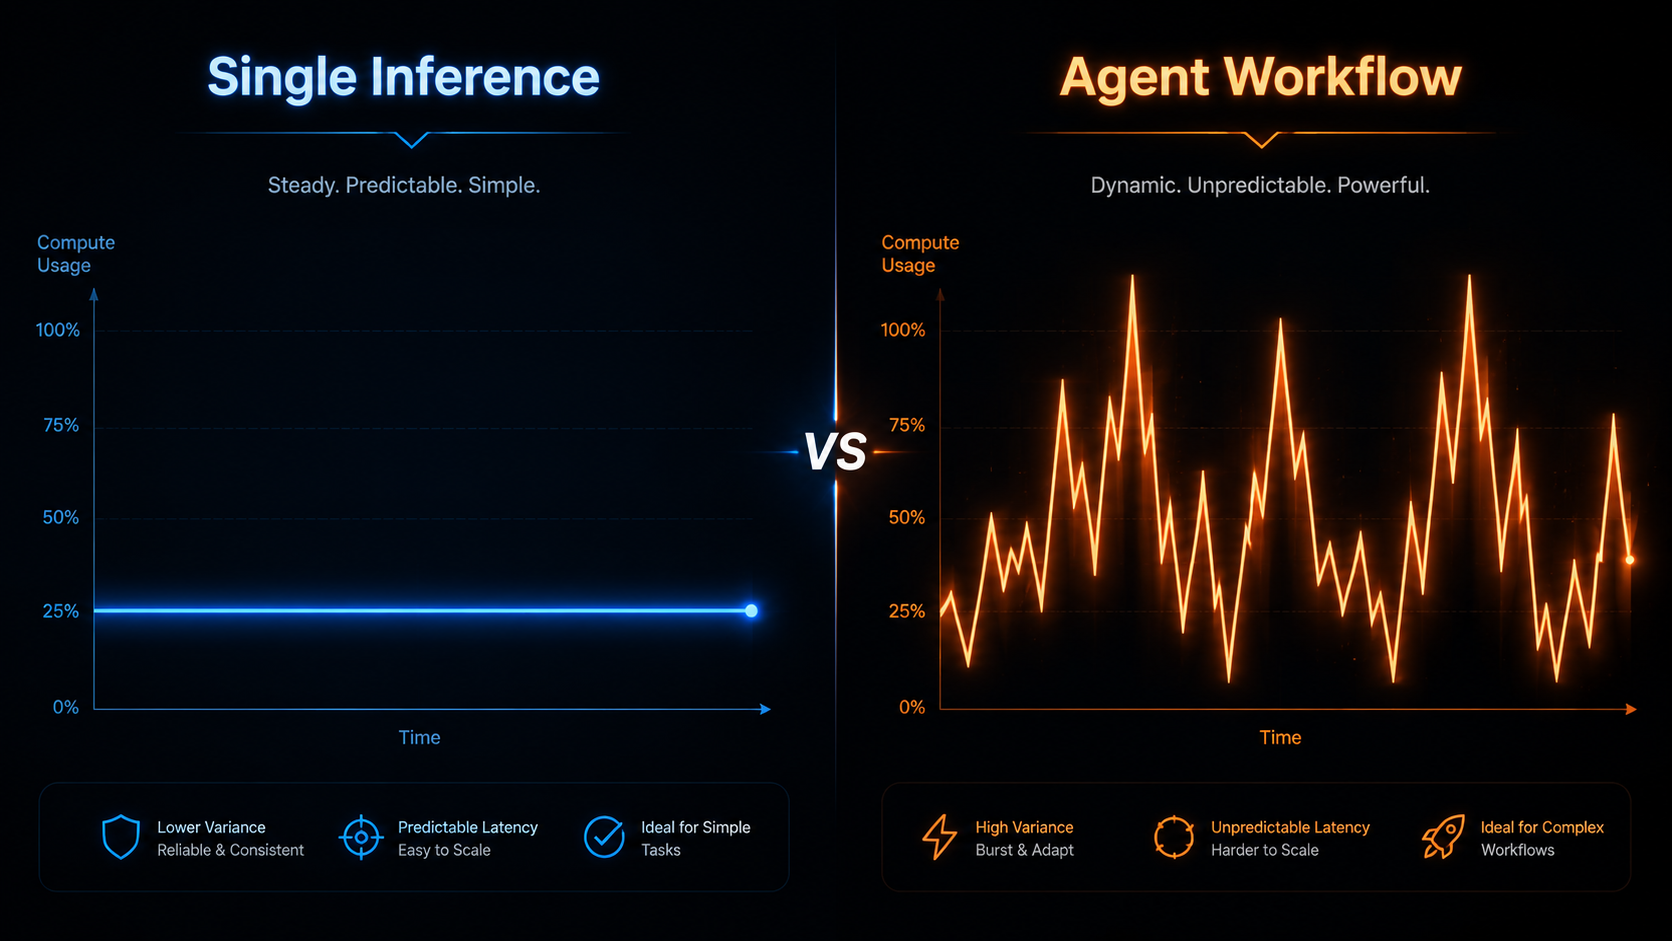
我们和不少做 Agent 的团队聊过,共识越来越清楚。Agent 跑起来的负载形状和单次模型调用完全两回事。 单次推理是平的,Agent 是 burst 单次推理是一个请求进来,跑完,出去,流量能画成一条平稳的线,配资源照着平均来就行。Agent 不是。它先规划,再循环,中途可能并行调一堆工具,某个...